Publications
Papers published at top conferences and journals.
Can Text-to-Video Generation help Video-Language Alignment?
Classifier-to-Bias: Toward Unsupervised Automatic Bias Detection for Visual Classifiers
Compositional Caching for Training-free Open-vocabulary Attribute Detection
Multi-focal Conditioned Latent Diffusion for Person Image Synthesis
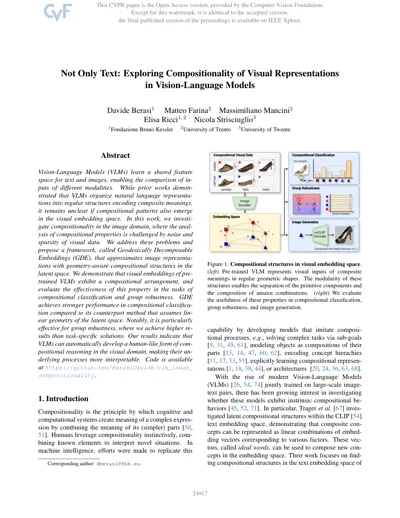
Not Only Text: Exploring Compositionality of Visual Representations in Vision-Language Models
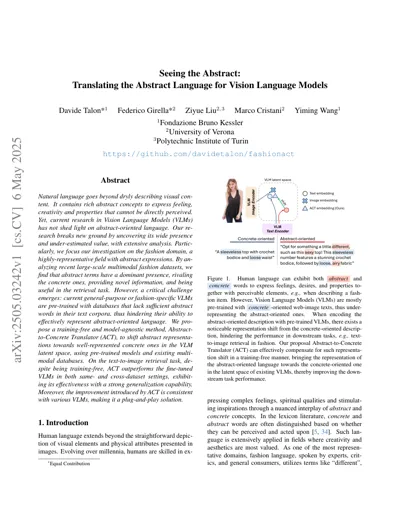
Seeing the abstract: Translating the abstract language for vision language models
WACV
2025 3 papers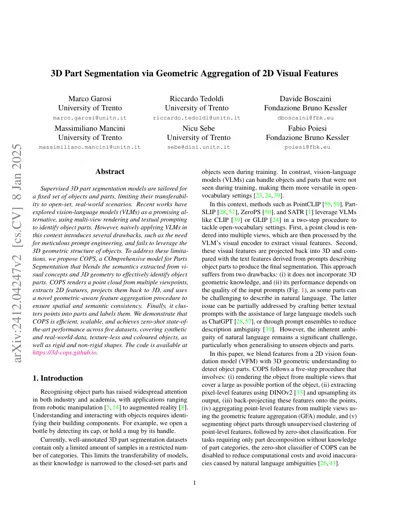
3D Part Segmentation via Geometric Aggregation of 2D Visual Features
One vlm to keep it learning: Generation and balancing for data-free continual visual question answering
CVIU
2025 1 paper
Collaborative Neural Painting
IEEE PAMI
2025 9 papersAnti-Forgetting Adaptation for Unsupervised Person Re-Identification
Diff9D: Diffusion-Based Domain-Generalized Category-Level 9-DoF Object Pose Estimation
GradBias: Unveiling Word Influence on Bias in Text-to-Image Generative Models
Reliable Few-Shot Learning Under Dual Noises
Spatial-Temporal Graph Mamba for Music-Guided Dance Video Synthesis
T2TD: Text-3D Generation Model Based on Prior Knowledge Guidance